
Observabilidade vs Monitoramento: O Que Sua PME Precisa?
Para a maioria das PMEs, monitoramento resolve a maior parte dos problemas operacionais: alertas, disponibilidade e tempo de resposta. Observabilidade complementa quando há incidentes sem causa conhecida ou dependências complexas. A Simples Solução TI, com operação no Rio de Janeiro e São Paulo, implementa essa combinação sob medida para cada empresa.
- Comece com monitoramento: métricas de disponibilidade, latência e erros com alertas acionáveis.
- Evolua para observabilidade quando o MTTR aumentar ou houver dependências entre 3+ sistemas.
- A Simples Solução TI atende PMEs no Rio de Janeiro e São Paulo e dimensiona a solução por diagnóstico.
- Valor de investimento depende de escopo: número de usuários, volume de dados e SLA.
O que sua PME deve escolher primeiro: monitoramento ou observabilidade?
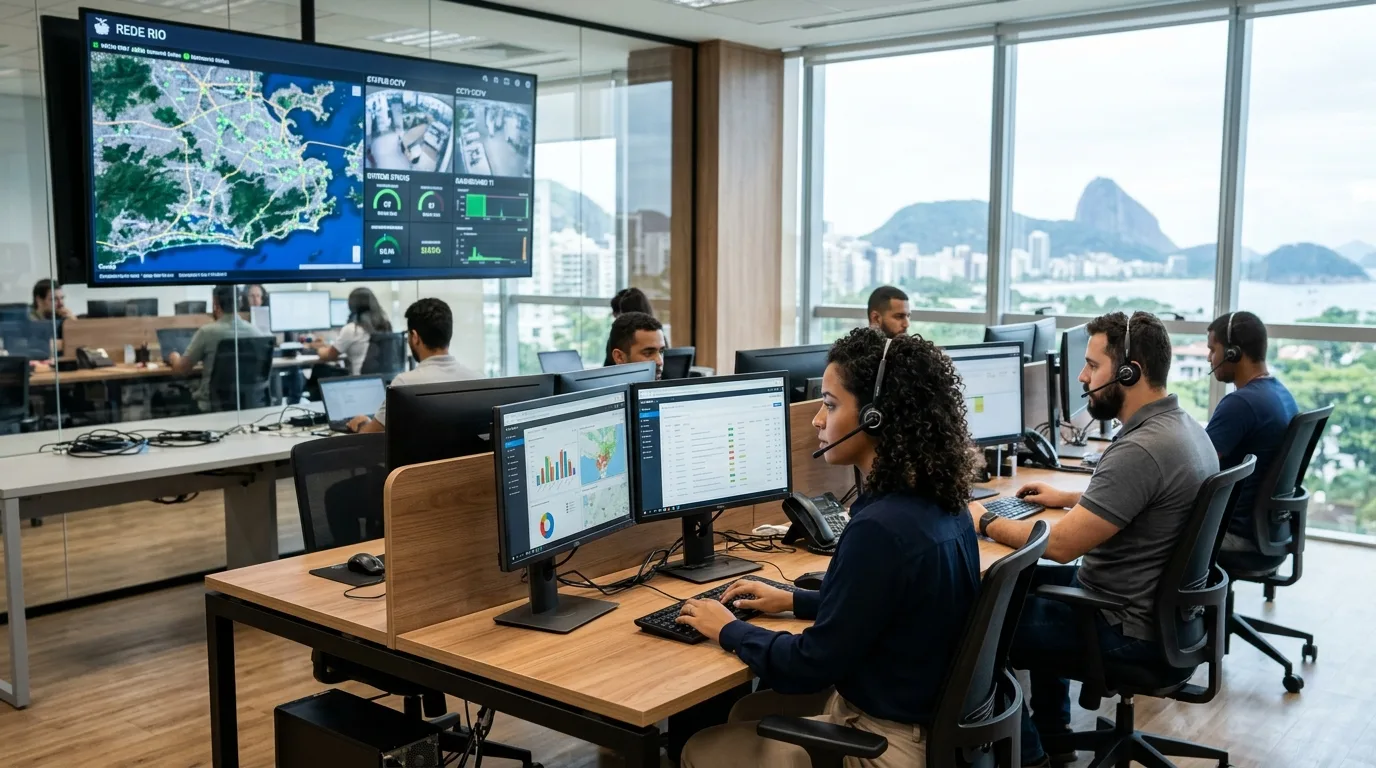
Para uma PME de 10 a 50 funcionários, comece com monitoramento. Ele entrega alertas de disponibilidade e performance para servidores, rede e backups com custo menor e configuração mais simples. A observabilidade só se torna prioridade quando o ambiente ganha microsserviços, containers ou integrações complexas que tornam a causa de incidentes não óbvia. A Simples Solução TI, com atendimento no Rio de Janeiro e São Paulo, implementa monitoramento inicial para PMEs usando Zabbix ou PRTG.
- Regra de decisão: se você opera até 20 servidores e aplicações monolíticas, comece com monitoramento.
- Exceção: se já usa Docker, Kubernetes ou integra ERPs com APIs e filas, adote observabilidade desde o início.
- Porte da equipe: se o time de TI é enxuto, priorize monitoramento gerenciado por um provedor como a Simples Solução TI, com atendimento no Rio de Janeiro e São Paulo.
Quais indicadores mostram que o monitoramento deixou de ser suficiente?
Cinco sinais indicam que sua PME precisa evoluir para observabilidade: MTTR crescente, dependências entre sistemas mascarando a causa raiz, alertas ignorados por excesso, mudanças frequentes gerando incidentes e problemas intermitentes sem rastro. Se dois ou mais aparecerem, é hora de reavaliar a estratégia.
- MTTR crescente: o tempo médio para reparo aumenta porque a causa não aparece nos alertas atuais; a equipe perde horas investigando manualmente.
- Dependências entre sistemas: uma falha no ERP afeta vendas e estoque, mas o alerta aponta apenas para o banco de dados, sem mostrar a cadeia de impacto.
- Fadiga de alertas: notificações demais fazem a equipe ignorar alertas críticos; o monitoramento perde credibilidade.
- Mudanças frequentes: cada deploy ou atualização gera incidentes difíceis de correlacionar com a mudança, indicando falta de tracing.
- Problemas intermitentes: falhas que desaparecem antes do diagnóstico exigem análise de logs centralizados e traces, não apenas métricas.
Ignorar esses sinais leva a downtime prolongado, perda de produtividade e pressão sobre a equipe. A Simples Solução TI usa esse checklist para propor um diagnóstico de observabilidade alinhado ao orçamento.
Como comparar ferramentas de monitoramento e observabilidade sem estourar o orçamento?
Compare ferramentas por três critérios: custo total (licença, infraestrutura e horas de configuração), curva de aprendizado da equipe e integração com a stack existente. Para PMEs, Zabbix ou Prometheus com Grafana costumam atender bem sem custo de licença; Datadog ou New Relic fazem sentido quando a equipe não pode dedicar tempo à manutenção.
| Critério | Open source (Zabbix, Prometheus + Grafana) | Comercial (Datadog, PRTG) |
|---|---|---|
| Custo de licença | Sem custo de licença; exige servidor próprio | Assinatura mensal por host ou usuário, valor sob consulta |
| Custo de infraestrutura | Servidor dedicado ou VM na nuvem | Geralmente SaaS, sem infraestrutura local |
| Curva de aprendizado | Média: exige conhecimento de Linux e configuração manual | Baixa: interface pronta e suporte comercial |
| Integração nativa | Ampla via plugins, mas requer ajustes | Integrações prontas para AWS, Azure, Kubernetes, etc. |
| Manutenção contínua | Alta: atualizações e ajustes por conta própria | Baixa: atualizações automáticas e suporte do fornecedor |
A título de exemplo, uma PME com 30 funcionários e 5 servidores pode começar com Zabbix e Grafana, sem custo de licença, investindo apenas em horas de configuração. Se a equipe de TI interna for mínima, um provedor como a Simples Solução TI gerencia a stack por contrato mensal, com atendimento no Rio de Janeiro e São Paulo.
Qual arquitetura mínima de telemetria uma PME de 10 a 50 funcionários deve adotar?
Para uma PME de 10 a 50 funcionários, a arquitetura mínima de telemetria tem três camadas: coleta, pipeline e visualização. Use OpenTelemetry para instrumentar aplicações, Fluent Bit para encaminhar logs e Grafana para dashboards e alertas. Comece com métricas e logs; só adicione traces quando houver chamadas distribuídas entre serviços.
A camada de coleta captura métricas de CPU, memória, disco e latência das aplicações, além de logs estruturados. O pipeline normaliza e encaminha os dados para armazenamento. A visualização consolida tudo em dashboards com alertas baseados em limites definidos.
Passo a passo: coleta, pipeline e visualização
- Instrumente as aplicações com OpenTelemetry SDK. Use auto-instrumentação para Java, Python, Node.js e .NET para minimizar código manual. Consequência de pular essa etapa: falta de correlação entre métricas, logs e traces.
- Instale o OpenTelemetry Collector como gateway central. Ele recebe dados dos agentes e exporta para Prometheus e Loki. Isso reduz a carga nos servidores de aplicação.
- Configure o Fluent Bit em cada servidor e estação para coletar logs do sistema operacional e das aplicações. Encaminhe os logs para o Loki via Collector ou diretamente.
- Suba um Prometheus para métricas e um Loki para logs, ambos conectados ao Grafana. Para uma PME, uma única instância de cada em um servidor virtual de médio porte é suficiente; a infraestrutura de servidores pode ser revisada pela consultoria de TI da Simples Solução TI.
- Crie dashboards no Grafana para visão executiva: taxa de erro, latência p95, uso de disco e disponibilidade por serviço. Configure alertas apenas para desvios críticos, não para todo ruído.
Retenha métricas por 30 dias e logs por 90 dias como ponto de partida. Ajuste conforme o volume; armazenar tudo por tempo demais custa espaço e dificulta a investigação. Se a equipe não tiver tempo para gerenciar a stack, considere um provedor de TI.
Quando contratar um provedor de TI para implementar monitoramento e observabilidade?
Contrate um provedor de TI quando a equipe interna não domina OpenTelemetry, Prometheus ou Grafana, ou quando incidentes recorrentes consomem horas produtivas. A Simples Solução TI atende PMEs de 10 a 50 funcionários no Rio de Janeiro e em São Paulo, com diagnóstico inicial e suporte contínuo.
O diagnóstico inicial mapeia quantos servidores, endpoints e aplicações precisam ser instrumentados. A partir daí, o provedor define a arquitetura, instala os coletores, configura dashboards e treina a equipe para o uso diário.
| Critério | Equipe interna | Provedor de TI (Simples Solução TI) |
|---|---|---|
| Tempo de implementação | 2 a 4 semanas em tempo parcial | 1 a 2 semanas com dedicação integral |
| Conhecimento necessário | OpenTelemetry, Prometheus, Grafana, Fluent Bit | Equipe já treinada nas ferramentas |
| Alerta e resposta a incidentes | Depende da disponibilidade da equipe | Suporte contínuo e abertura de chamados |
| Custo | Horas internas + infraestrutura | Investimento previsível, definido após diagnóstico |
Se a empresa tem um time de TI interno, o provedor pode atuar como extensão especializada, revisando configurações e assumindo a operação do monitoramento. O suporte em informática da Simples Solução TI cobre desde a manutenção preventiva até a resposta a falhas.
Quais erros comuns invalidam um projeto de observabilidade em PMEs?
Os erros mais comuns em observabilidade são alertas excessivos, retenção inadequada e coleta sem contexto. Eles geram fadiga de alerta, custos desnecessários e investigações lentas. A correção é imediata: menos alertas, retenção ajustada e dados rotulados.
- Erro: alertar para cada métrica fora do normal. Correção: defina alertas apenas para SLOs críticos, como taxa de erro acima de 1% ou latência p95 acima de 500 ms em 5 minutos. Use Prometheus Alertmanager para agrupar e silenciar alertas redundantes.
- Erro: reter logs e métricas para sempre. Correção: retenha métricas por 30 dias e logs por 90 dias. Traces podem ser amostrados e retidos por 7 dias. Ajuste conforme investigações reais.
- Erro: coletar tudo sem rótulos (labels). Correção: adicione labels como serviço, ambiente, versão e cliente em toda telemetria. Isso permite filtrar no Grafana e correlacionar incidentes.
- Erro: ignorar logs ou traces e focar só em métricas. Correção: métricas mostram o sintoma; logs e traces mostram a causa. Ative logs estruturados em JSON e traces com OpenTelemetry para correlacionar.
- Erro: tratar observabilidade como projeto único e abandonar a manutenção. Correção: reavalie dashboards e alertas mensalmente. Remova o que não é usado e ajuste limites conforme a operação muda.
A Simples Solução TI revisa configurações existentes para eliminar esses erros e ajustar a telemetria à rotina da PME. O diagnóstico identifica gargalos e propõe correções sem trocar toda a stack.
Perguntas frequentes
Estou recebendo alertas demais e minha equipe ignora a maioria. O que fazer primeiro?
Reduza os alertas para apenas os que exigem ação, priorizando severidade e impacto no negócio. Regra: mantenha alerta se a falha afeta usuários ou faturamento; caso contrário, transforme em log ou métrica para investigação. Ignorar esse ajuste gera fadiga de alerta e oculta incidentes reais.
Meu sistema caiu e não sei se foi banco, aplicação ou rede. Qual abordagem resolve mais rápido?
Adote observabilidade com tracing distribuído usando OpenTelemetry para correlacionar as dependências e apontar a causa raiz. Se sua stack tem microsserviços ou APIs entre sistemas, essa é a regra; caso contrário, monitoramento com métricas e logs pode bastar. Sem tracing, você gastará horas olhando dashboards isolados.
Quando devo trocar meu monitoramento atual por observabilidade?
Troque quando o MTTR estiver alto, incidentes intermitentes sem rastro ou mudanças frequentes causarem falhas. Use observabilidade se você tem mais de uma fonte de telemetria e dificuldade para isolar falhas; caso contrário, continue com monitoramento e invista em alertas melhores. Adiar essa mudança aumenta o tempo de indisponibilidade.
Como escolher entre Zabbix, Prometheus e Grafana sem estourar orçamento?
Compare custo total (licença, infraestrutura e horas de configuração), curva de aprendizado e integração com sua stack. Regra: se sua equipe já domina Linux e tem tempo interno, Prometheus + Grafana reduzem licenças. Exceção: se precisa de suporte comercial e pouco esforço de configuração, avalie ferramentas gerenciadas ou um provedor como a Simples Solução TI.
Preciso instrumentar minha aplicação, mas não tenho equipe de DevOps. O que fazer?
Comece com OpenTelemetry SDK nas linguagens que já usa, mesmo sem DevOps dedicado. Se a complexidade for alta, contrate um provedor de TI para implementar a coleta, pipeline e visualização. Ignorar a instrumentação deixa você sem dados para investigar a próxima falha.
Quais erros fazem um projeto de observabilidade falhar em PMEs?
Evite três erros: alertas excessivos, retenção curta demais e coleta sem contexto de negócio. Regra: retenha métricas por pelo menos 30 dias e logs por 90 dias para comparar tendências. Exceção: se o volume for enorme e o custo proibitivo, reduza a retenção apenas para dados de depuração, nunca para segurança.
Minha PME tem 15 funcionários e só um servidor. Observabilidade é overkill?
Sim, comece com monitoramento básico de infraestrutura e aplicação. Use observabilidade apenas quando houver dependências entre serviços ou incidentes sem causa óbvia. Para uma PME pequena, investir cedo demais em tracing complexo consome verba sem retorno.